

نوول Spatio-Temporal Continuous Sign Language Recognition استعمال کرتے ہوئے ایک توجہ دینے والے ملٹی فیچر نیٹ ورک(2)
Jun 01, 2023
3.5 تسلسل سیکھنا
ترتیب سیکھنا مقامی اور وقتی خصوصیت کے ایکسٹریکٹر سے ایک گلوس فیچر کی شکل میں نتائج حاصل کرنے کے بعد، ہمیں انہیں ایک مکمل جملے میں ترتیب دینے کی ضرورت ہے۔ لہٰذا، ہمیں اس بات کو یقینی بنانے کے لیے ترتیب سیکھنے کا استعمال کرنے کی ضرورت ہے کہ چمک ایک اچھے جملے کی تشکیل کے لیے منظم ہو۔ موجودہ تحقیق میں سب سے زیادہ مروجہ طریقہ سے مراد بائی ڈائریکشنل لانگ شارٹ ٹرم میموری (Bi-LSTM) اور کنکشنسٹ ٹیمپورل کلاسیفیکیشن (CTC) [17,23] ہے جو کہ CTC اور کئی حالیہ کاموں [17,23] کے ذریعے حل کیے جاسکتے ہیں۔ CTC CSLR کے لیے آخر سے آخر تک تربیتی عمل کے طور پر۔
Cistanche نچوڑ پاؤڈر
Cistanche مصنوعات کو دیکھنے کے لیے یہاں کلک کریں۔
【مزید پوچھیں】 ای میل:cindy.xue@wecistanche.com / واٹس ایپ: 0086 18599088692 / وی چیٹ: 18599088692
لانگ شارٹ ٹرم میموری (LSTM) [44] ریکرنٹ نیورل نیٹ ورک (RNN) کی ایک قسم ہے، اور یہ ترتیب ماڈلنگ میں بڑے پیمانے پر استعمال ہوتی ہے۔ LSTM طویل مدتی انحصار کو بہترین انداز میں پیش کرتا ہے۔ یہ ان پٹ کے پورے سلسلے کو پروسیس کر سکتا ہے اور ریاستی ٹرانزیشن کو ماڈل کرنے کے لیے ان کی اندرونی حالت کا استعمال کر سکتا ہے۔ تاہم، ان فارورڈ آر این این کی کمی یہ ہے کہ چھپی ہوئی ریاستیں صرف ایک طرفہ سمت سے سیکھی جاتی ہیں۔ RNN ایک پوشیدہ حالت پیدا کرتا ہے جیسا کہ ان پٹ کے طور پر خصوصیت کی ترتیب حاصل کرنے کے بعد ذیل میں مساوات کے ذریعہ بیان کیا گیا ہے۔
ht=RNN(ht−1,ot),
جہاں ht پوشیدہ حالت کی نمائندگی کرتا ہے، جہاں ابتدائی حالت h0 ایک مقررہ تمام صفر ویکٹر ہے، اور t وقت کا مرحلہ ہے۔ RNN کا استعمال مقامی خصوصیت کی ترتیب کے ان پٹ کے مطابق نشانی کی چمک کی پیش گوئی کرنے کے لیے کیا جاتا ہے۔
مزید یہ کہ ایس ایل کام کافی پیچیدہ ہیں۔ لہٰذا، اسے نہ صرف یک طرفہ سیاق و سباق سے موصول ہونے والی خصوصیات کی ضرورت ہوتی ہے بلکہ جملے میں دوسرے الفاظ سے پہلے اور بعد میں آنے والے الفاظ کی موجودگی کو جاننے کے لیے دو طرفہ معلومات کے استعمال میں بھی مدد کی ضرورت ہوتی ہے۔ نتیجتاً، ہم Bi-LSTM [45] کا استعمال کرتے ہیں تاکہ تصویری ترتیب کے پیچیدہ متحرک انحصار کو سیکھنے کے لیے انہیں مقامی اور وقتی نمائندگیوں کا استعمال کرتے ہوئے چمکیلی خصوصیات کے سلسلے میں تبدیل کیا جائے۔ پہلے بیان کی گئی وضاحت کے مطابق، Bi-LSTM طریقہ LSTM طریقہ کے ساتھ دو طرفہ کام انجام دے سکتا ہے۔ اس کا مطلب ہے کہ Bi-LSTM طریقہ ترتیب وار ڈیٹا کی بہتر درجہ بندی کر سکتا ہے۔ Bi-LSTM کی گنتی جو دو طرفہ پوشیدہ حالتوں کا استعمال کرتی ہے اسے LSTM کی بار بار کی گنتی کے طور پر بھی دیکھا جا سکتا ہے جو آگے سے پیچھے اور پھر پیچھے سے آگے پر عملدرآمد کیا جاتا ہے۔ اس کے بعد، ہر بار قدم کی پوشیدہ حالت ایک مکمل طور پر منسلک پرت اور ایک سافٹ میکس پرت سے گزرتی ہے [17]۔

Cistanche پاؤڈر
= W(ht جمع b) پر،
yt,j=e at,j ∑ke at,j،
جہاں b ایک تعصب ویکٹر ہے اور y(t,j) مرحلہ t پر لیبل j کے امکان کو ظاہر کرتا ہے۔ ہمارے TSL ٹاسک میں، لیبل j وہ ذخیرہ الفاظ ہے جو جملے سے حاصل کی جاتی ہے۔ عملی طور پر، Bi-LSTM ان معلومات کی مقدار کو نمایاں طور پر بہتر بناتا ہے جو نیٹ ورک تک رسائی حاصل کر سکتا ہے، جس کے نتیجے میں الگورتھم میں دستیاب معلومات کے تناظر میں بہتری آتی ہے۔ معلومات میں اس بات کا علم ہوتا ہے کہ کون سا لفظ جملہ فیچر سیکونس ان پٹ میں موجودہ فریم کے بعد یا اس سے پہلے آتا ہے۔
Bi-LSTM ہر بار قدم کے لیے پوشیدہ ریاستوں کو آؤٹ پٹ کے طور پر CTC پرت کو بھیجتا ہے۔ چونکہ اس Bi-LSTM کے نتائج چمک کے انتظام پر توجہ نہیں دیتے ہیں، اس لیے ہم CTC کا استعمال کرتے ہیں تاکہ ویڈیو کی ترتیب کی نقشہ سازی o={ot} T 0 t=1 کو نشانی بنایا جاسکے۔ چمک کی ترتیب `={` i} IL =1 (T سے کم یا اس کے برابر) بہتر ترتیب کے ساتھ۔ CTC بہت سے شعبوں میں استعمال ہوتا ہے، بشمول ہینڈ رائٹنگ کی شناخت [46]، تقریر کی شناخت [47]، اور اشاروں کی زبان کی شناخت [17,23]۔ اس ڈومین میں، یہ ان پٹ اور آؤٹ پٹ کی ترتیب کو سیدھ میں لائے بغیر اسکورنگ فنکشن کے طور پر استعمال ہوتا ہے۔ سی ایس ایل آر میں، سی ٹی سی ایک ماڈیول کے طور پر جانا جاتا ہے جو اختتام سے آخر تک کاموں کے لیے تیار کیا گیا ہے جس میں بغیر کسی تقسیم کے عارضی ڈیٹا کی درجہ بندی شامل ہے۔ ڈائنامک پروگرامنگ کے ذریعے، سی ایس ایل آر ایک خالی لیبل (-) بنا کر صف بندی کے مسئلے کو حل کر سکتا ہے جو سسٹم کو ایسے ڈیٹا کی نمائندگی کے لیے بہترین نتائج پیدا کرنے کی اجازت دیتا ہے جس میں لیبل نہیں ہیں (جیسے ایپینتھیسس ڈیٹا اور غیر اشارہ ڈیٹا کے حصے)۔ خاص طور پر، CTC ایک خالی لیبل "-" تیار کرتا ہے تاکہ ذخیرہ الفاظ V کو بڑھایا جا سکے، جہاں V=Vorigin ∪ {-}۔ اس خالی لیبل کا مقصد منتقلی کی نمائندگی کرنا اور ایک خالی چمک کے وجود کو مطلع کرنا ہے جو سیکھنے کے عمل کے لیے معلومات فراہم نہیں کرتا، جیسا کہ π={πt} T 0 t{{20 }}، جہاں πt ∈ V۔ نتیجتاً، CTC تمام ممکنہ راستوں کے امکانات کا خلاصہ کرکے مقامی اور عارضی فیچر ایکسٹریکٹر سے آؤٹ پٹ پیرامیٹرز اور Bi-LSTM کو الائنمنٹ ماڈیول کے طور پر بھی منظم کر سکتا ہے۔ تمام سیدھ کے راستے π میں ایک امکان ہے جسے درج ذیل کے طور پر ان پٹ ترتیب دیا گیا ہے [17]:

Cistanche deserticola تجربہ
p(π| o) {{0}} T 0 ∏ t=1 p(πt|o)=T 0 ∏ t=1 yt، πt
اگلے مرحلے میں، ہم متعدد سے ایک میپنگ آپریشن B کی وضاحت کرتے ہیں، جو کسی بھی خالی جگہ کو ہٹاتا ہے اور صف بندی کے راستے سے الفاظ کو نقل کرتا ہے۔ مثال کے طور پر، B (II-am- -a- -doctor)=I, am, a, doctor۔ نتیجے کے طور پر، ہم نشانی چمک کی ترتیب l کے مشروط امکان کو ان تمام راستوں کے کل امکانات کے طور پر شمار کر سکتے ہیں جو B سے l تک نقشہ بنا سکتے ہیں، ذیل میں بیان کردہ طریقے سے [17]:
p(π|o) = ∑ π∈B−1 p(π|o)
جہاں B −1 (l)={π|B(π)=l} B کا الٹا عمل ہے۔ آخر میں، خصوصیت کی ترتیب کے CTC نقصانات کی وضاحت اس طرح کی گئی ہے [17]:
Lctc=− ln p(` |o)
مشروط امکان p(π|X) مشروط آزادی کے مفروضے کے مطابق شمار کیا جا سکتا ہے۔
4. تجرباتی نتائج اور بحث
میرے نزدیک Cistanche ضمیمہ - یادداشت کو بہتر بنائیں
اس سیکشن میں، ہم مجوزہ ترتیب کے ساتھ اپنے تجربے کی تفصیلات بیان کریں گے جیسا کہ پہلے حصے میں بیان کیا گیا ہے۔
4.1 ڈیٹاسیٹس
اس سیکشن میں، ہم ان ڈیٹاسیٹس کی وضاحت کرتے ہیں جنہیں ہم نے اس تجربے کے دوران استعمال کیا۔ ہم نے دو ڈیٹاسیٹ استعمال کیے، پہلا CSL ڈیٹاسیٹ [8,40,41] اور دوسرا RWTH-PHOENIX ڈیٹاسیٹ [33,39]۔ یہ دونوں ڈیٹا سیٹس مسلسل اشاروں کی زبان کے ڈیٹا سیٹس ہیں، جو اشاروں کی کچھ سیریز کو مکمل جملے میں ترجمہ کرنے کے لیے استعمال ہوتے ہیں۔
4.1.1 CSL ڈیٹاسیٹ
سی ایس ایل ڈیٹاسیٹ کو کئی کاموں میں استعمال کیا گیا ہے [8,40,41]۔ اس ڈیٹا سیٹ میں کل 100 جملے اور 178 الفاظ موجود ہیں، جو عام طور پر روزمرہ کے رابطے میں استعمال ہوتے ہیں۔ یہ ڈیٹا سیٹ اوسطاً فی جملہ 5 الفاظ پر مشتمل ہے۔ ہر جملہ 50 دستخط کنندگان نے 5 بار ادا کیا۔ اس طرح، ویڈیوز کی کل تعداد 25،000 ہے، جو اسے سب سے بڑے ڈیٹا سیٹس میں سے ایک بناتی ہے۔ اپنے CSL ماڈل کو تربیت دینے کے لیے، ہم نے ڈیٹا سیٹ کو 20،{11}} ویڈیوز کے ساتھ تربیت کے لیے ڈیٹا میں تقسیم کیا اور ایک ہی جملے کے لیکن مختلف دستخط کنندگان کے ساتھ 5000 ویڈیوز کے ساتھ جانچ کے لیے۔
4.1.2 RWTH-PHOENIX ڈیٹاسیٹ
RWTH-PHOENIX ڈیٹاسیٹ [33,39] ایک جرمن اشاروں کی زبان کا ڈیٹاسیٹ ہے، جو جرمنی کے ٹیلی ویژن اسٹیشنوں سے عوامی موسم کی نشریات کی ریکارڈنگ ہے۔ اس ویڈیو کو اس طرح پروسیس کیا گیا ہے کہ اس کا سائز 210 × 260 ہے۔ 6841 مختلف جملے ہیں جن پر 9 مختلف دستخط کنندگان کے دستخط ہیں۔ تمام دستخط کرنے والوں نے ہلکے رنگ کے پس منظر پر گہرے رنگ کے کپڑے پہنے تھے۔ مجموعی طور پر، تقریباً 80،000 چمک کے ساتھ 1232 الفاظ ہیں۔ اس ڈیٹاسیٹ کو پہلے سے طے شدہ فارمیٹ کے مطابق تقسیم کیا گیا ہے، جس میں 5672 تربیتی نمونے، 540 توثیق/ڈیو نمونے، اور 629 ٹیسٹ کے نمونے شامل ہیں۔
4.2 ڈیٹا پری پروسیسنگ
پہلی چیز جو ہمیں کرنے کی ضرورت تھی وہ ہمارے مجوزہ ماڈل کو فٹ کرنے کے لیے اپنے ڈیٹاسیٹ کو پری پروسیس کرنا تھا۔ جیسا کہ شکل 3 سے واضح کیا گیا ہے، ہم نے سائز تبدیل کرنے اور فصل کی کٹائی کی۔ بائیں جانب، ہم دیکھ سکتے ہیں کہ اصل ڈیٹا کا سائز فل ایچ ڈی یا 1920 × 1080 ریزولوشن میں تھا۔ ہمیں اسے 224 × 224 ریزولوشن میں تراشنے اور اس کا سائز تبدیل کرنے کی ضرورت ہے کیونکہ ہمارا مقامی ماڈیول ان پٹ وصول کرتا ہے جو ResNet50 ان پٹ کے سائز کا ہے۔ اس کے بعد، ہم نے ڈیٹا کو اپنے مقامی ماڈل میں فیڈ کیا، جو ایک تصویر سے 7 × 7 ٹینسر تیار کرے گا۔
پہلے سے تیار شدہ مکمل فریم امیج کو پھر کلیدی پوائنٹ کی خصوصیات بنانے کے لیے استعمال کیا گیا۔ ہم نے ان RGB امیجز سے 133 اہم نکات کی پیشین گوئی کرنے کے لیے HRNet ماڈل کا استعمال کیا۔ تاہم، ہم اپنے مجوزہ ماڈل میں صرف اوپری جسم کے 27 کلیدوں کا استعمال کرتے ہیں۔ کلیدی پوائنٹ کی خصوصیات کے لیے ان پٹ کا سائز 27 × 3 ہے کیونکہ ہمارے پاس 3- محور (x، y، اور z) کوآرڈینیٹ ڈیٹا فی پوائنٹ ہے۔ ماڈل کی ان پٹ ڈائمینشن مکمل فریم فیچر کے لیے N × 224 × 224 × 3 اور کلیدی پوائنٹ ان پٹ کے لیے N × 1 × 27 × 3 ہے، جہاں N فریموں کی تعداد ہے۔ ڈیٹاسیٹ کے تغیرات کو بڑھانے کے لیے، ہم [12] سے اضافے کی پیروی کرتے ہیں، بشمول بے ترتیب کراپنگ، افقی پلٹنا، اور بے ترتیب وقتی اسکیلنگ۔ رینڈم کراپنگ کو بھی اصل تصویر کو تراشنے کے لیے پری پروسیسنگ مرحلے کے حصے کے طور پر استعمال کیا جاتا ہے۔

میرے نزدیک Cistanche ضمیمہ - یادداشت کو بہتر بنائیں
4.3 تشخیص میٹرک
اپنے مجوزہ ماڈل کی شناخت کی کارکردگی کا جائزہ لینے کے لیے، ہم لفظ کی غلطی کی شرح (WER) میٹرک کا استعمال کرتے ہیں، جو کہ ایک میٹرک ہے جو عام طور پر CSLR میں کسی پیش گوئی کردہ جملے کی شناخت کی درستگی کا اندازہ لگانے کے لیے استعمال ہوتا ہے، جیسا کہ ذیل کی مساوات سے دکھایا گیا ہے [17]:
WER=S جمع I جمع DT=S جمع I جمع DS جمع C جمع D
جہاں S اصل لفظ کے متبادل کی تعداد ہے، I وہ داخلوں کی تعداد ہے جو اصل جملے میں نہیں ہیں، D حذف کیے جانے والوں کی تعداد ہے جو اصل جملے میں ہونی چاہیے تھی، C صحیح الفاظ کی تعداد ہے جو مماثل ہیں اصل جملہ، اور T جملے میں الفاظ کی کل تعداد ہے یا جو متبادل، حذف اور درست الفاظ کی کل تعداد سے حاصل کی جا سکتی ہے۔ CSL کے لیے، ہر حرف کو ایک لفظ کی نمائندگی کرنے کے لیے استعمال کیا جاتا ہے۔
4.4 ان پٹ اسٹریمز پر تجربہ کریں۔
یہ تجربہ بنیادی طور پر ہمارے ماڈل پر سنگل اسٹریم اور ملٹی اسٹریم ان پٹ کا موازنہ کرنے پر مرکوز ہے۔ مقصد ان پٹ سٹریم کی بہترین کنفیگریشن تلاش کرنا ہے۔ ہم اس تجربے میں صرف RWTH-PHOENIX ڈیٹاسیٹ استعمال کرتے ہیں۔ ہمارے ماڈل کو دو الگ الگ ان پٹ ملیں گے، مکمل فریم اور کلیدی پوائنٹ۔ سنگل سٹریم ان پٹ فل فریم امیج سے صرف RGB فیچر استعمال کرتا ہے۔ دو سنگل سٹریم ان پٹ تجربات ہیں۔ پہلا صرف آر جی بی امیج سے مکمل فریم فیچر استعمال کرتا ہے، اور دوسرا کلید پوائنٹ ان پٹ سے کلیدی پوائنٹ فیچر استعمال کرتا ہے۔ ملٹی اسٹریم ان پٹ جو ہم تجویز کرتے ہیں اس میں RGB اور کلیدی پوائنٹ کی خصوصیات شامل ہیں۔ سنگل سٹریم اور ملٹی سٹریم کا استعمال کرتے ہوئے موازنہ کا نتیجہ ٹیبل 1 میں دکھایا گیا ہے۔ یہاں، ہم دیکھ سکتے ہیں کہ ملٹی سٹریم فیچر کا استعمال کر کے ہم ایک ہی سٹریم کے استعمال سے بہتر نتیجہ حاصل کر سکتے ہیں۔ مرکزی دھارے کو مکمل فریم RGB خصوصیت سے حاصل کیا جاتا ہے اور اضافی سلسلہ کلیدی پوائنٹ کی خصوصیات کا استعمال کرتا ہے۔ اضافی کلیدی نکتہ سلسلہ ماڈل کو بہتر طریقے سے سیکھنے میں مدد کرتا ہے، خاص طور پر ہاتھ کی شکل کی تفصیلات کو حاصل کرنے میں۔
جدول 1. سنگل اسٹریم اور ملٹی اسٹریم ان پٹ کا استعمال کرتے ہوئے WER کارکردگی کا موازنہ۔

4.5 توجہ کے ماڈیول پر تجربہ کریں۔
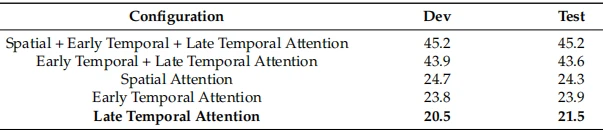
اس تجربے کا مقصد توجہ کے ماڈیول کی بہترین ترتیب کا انتخاب کرنا تھا۔ اس تجربے میں، ہم پچھلے تجربے کے نتائج اور اسی ڈیٹا سیٹ سے بہترین نتائج کی ترتیب کا استعمال کرتے ہیں۔ ہم مقامی توجہ کو ماڈل کے طور پر ظاہر کرتے ہیں جس میں ہر خصوصیت کے لیے مقامی ماڈیول کے آخر میں خود دھیان دینے والی پرت ہوتی ہے۔ ابتدائی وقتی توجہ پہلی عارضی پولنگ کے بعد خود توجہ کی پرت ہے، اور دیر سے عارضی توجہ دوسری دنیاوی پولنگ کے بعد خود توجہ کی پرت ہے۔ یہاں، ہم اوپر کی تمام ترتیبوں اور مقامی اور وقتی توجہ کے امتزاج کا موازنہ کریں گے۔ نتیجہ ٹیبل 2 میں دکھایا گیا ہے۔ مقامی توجہ کا نتیجہ وقتی توجہ سے بدتر ہے۔ مقامی سطح ہر فریم کے لیے خصوصیات کی ایک ترتیب پر مشتمل ہے۔ جیسا کہ [20] میں ذکر کیا گیا ہے، خود توجہ کی پرت طویل انحصار کے درمیان چھوٹا راستہ سیکھنا آسان ہے۔ لہذا، طویل ترتیب کی وجہ سے مقامی توجہ WER کو کم کرنے میں ناکام رہتی ہے۔ دوسری طرف، ہم اسے پولنگ کے بعد رکھ کر وقتی توجہ کا استعمال کرتے ہوئے ایک بہتر نتیجہ حاصل کرنے میں کامیاب ہو گئے تھے تاکہ اس کی ترتیب کی لمبائی کم ہو۔ دیر سے توجہ جس کی ترتیب کی لمبائی مختصر ترین ہوتی ہے بہترین نتیجہ حاصل کرتی ہے۔ مزید یہ کہ مقامی اور دنیاوی میں توجہ کے ماڈیول کا امتزاج صرف ایک ہی توجہ کے استعمال سے بدتر ہے۔ ان نتائج کی بنیاد پر، ہم آگے کے تجربات کے لیے بہترین ترتیب کا اطلاق کرتے ہیں۔
جدول 2. مختلف توجہ کی ترتیب کا استعمال کرتے ہوئے WER کارکردگی کا موازنہ
4.6 STAMF نیٹ ورک پر ختم کرنے کا تجربہ
مزید برآں، ہم اسی ڈیٹاسیٹ اور ان پٹ سٹریم اور توجہ کے ماڈیول کی بہترین کنفیگریشن کا استعمال کرتے ہوئے ایک ایبلیشن تجربہ کرتے ہیں۔ بغیر پولنگ کے دیر سے وقتی توجہ کا استعمال کرتے ہوئے ایک تجربے پر جدول 3 یہ ثابت کرتا ہے کہ ترتیب کی لمبائی توجہ کی کارکردگی کو متاثر کرتی ہے۔ وہ تجربات جو کم ترتیب کی لمبائی کے ساتھ پولنگ تہوں کا استعمال کرتے ہیں بہتر نتائج حاصل کرتے ہیں۔ ہم ترتیب سیکھنے کے لیے مختلف ماڈلز کا استعمال کرتے ہوئے کارکردگی کو جاننے کے لیے ایک ایبلیشن تجربہ بھی کرتے ہیں۔ جدول 4 میں نتیجہ ظاہر کرتا ہے کہ LSTM کا استعمال، جس میں صرف ایک طرفہ معلومات ہوتی ہے، Bi-LSTM کے استعمال سے کم کارکردگی رکھتی ہے، جس میں دو طرفہ معلومات ہوتی ہیں۔
جدول 3. مختلف دیر سے وقتی توجہ کی ترتیب کا استعمال کرتے ہوئے WER کارکردگی کا موازنہ۔

جدول 4. مختلف ترتیب سیکھنے کی ترتیب کا استعمال کرتے ہوئے WER کارکردگی کا موازنہ۔

4.7 STAMF نیٹ ورک پر تجربہ کریں۔
اس سیکشن میں، ہم اپنے مجوزہ ماڈل کے لیے مکمل تربیتی عمل کی وضاحت کرتے ہیں جسے spatiotemporal attentive multi-feature (STAMF) کہتے ہیں۔ یہ اس بات کا احاطہ کرے گا کہ ہم کس طرح اپنے ان پٹ ڈیٹا کو مقامی ماڈیول، عارضی ماڈیول، اور ترتیب سیکھنے کے ماڈیول میں مرحلہ وار فٹ کرتے ہیں۔ اس سیکشن میں، ہم ملٹی اسٹریم ان پٹ اور دیر سے وقتی توجہ کی ترتیب کا استعمال کرتے ہیں۔
4.7.1 نفاذ کی تفصیلات
ہم 224 × 224 سائز والے ان پٹ فریموں کا استعمال کرتے ہوئے اینڈ ٹو اینڈ ٹریننگ اور ٹیسٹنگ انجام دیتے ہیں۔ آپٹیمائزر کے لیے، ہم سیکھنے کی شرح کے طور پر 10−4 کے ساتھ ایڈم آپٹیمائزر کا استعمال کرتے ہیں اور CSL کے لیے 10 اور 15 کے دور میں اسے 2 سے تقسیم کرتے ہیں۔ RWTH PHOENIX کے لیے 30، 40، اور 60 کے عہد۔ ہم نے بیچ کا سائز 4 پر سیٹ کیا اور RWTH-PHOENIX کے لیے 80 عہد اور CSL کے لیے 20 دور انجام دیتے ہیں۔ تربیت اور جانچ NVIDIA Tesla V100 اور 128G RAM پر چلائی گئی۔
سب سے پہلے، ہم نے ResNet50 کا استعمال کرتے ہوئے RGB اسٹریمز سے فیچر نکالا اور کلیدی پوائنٹ حاصل کرنے کے لیے HRNet کا استعمال کیا اور پھر ResNet50 کا استعمال کرتے ہوئے کلیدی پوائنٹ کی خصوصیات کو نکالا۔ نوٹ کریں کہ ہم ترتیب وار ڈیٹا یا ویڈیو کے ساتھ کام کر رہے تھے۔ لہذا، ہمیں ویڈیو کی لمبائی کے لحاظ سے اپنے ان پٹ سائز کو ترتیب دینے کی ضرورت ہے۔ تکنیکی وجوہات کی بنا پر، تمام ڈیٹا کے لیے ان پٹ کا سائز ایک دوسرے سے یکساں ہونا ضروری ہے۔ لہذا، ہمیں اپنے ڈیٹاسیٹ میں سب سے طویل ویڈیو کو جاننا چاہیے، پھر ہم نے اپنے ان پٹ فریم کی لمبائی کو سب سے بڑے فریم نمبر سے ملنے کے لیے پیڈ کیا
یہ ترتیب وار نکالی گئی خصوصیات عارضی ماڈیول کے ذریعہ استعمال کی گئیں۔ ہر ترتیب وار سلسلہ دو اسٹیک شدہ عارضی پولنگ سے گزرتا ہے۔ ہر وقتی پولنگ ایک 1-جہتی کنوولیشنل نیٹ ورک اور ایک زیادہ سے زیادہ پولنگ پرت پر مشتمل تھی، جس نے ترتیب کی لمبائی نصف تک کم کردی۔ دونوں اسٹریمز سے عارضی پولنگ کا آؤٹ پٹ اس کے بعد توجہ کی پرت سے منسلک تھا اور آخری وقتی پولنگ کے لیے، توجہ کی پرت کے بعد، اسے آخر میں عارضی ماڈیول آؤٹ پٹ کے طور پر جوڑا گیا تھا۔
دنیاوی پیداوار کو ترتیب سیکھنے کے ماڈیول کے ذریعہ پروسیس کیا گیا تھا۔ اس عمل میں CTC کے ساتھ منسلک Bi-LSTM پرت کا استعمال کیا گیا تاکہ حتمی سیدھ حاصل کی جا سکے اور چمک کو حتمی جملے میں تحریر کیا جا سکے۔
4.7.2 مقداری نتیجہ
WER سکور کو مقداری نتیجہ کے طور پر شمار کرنے کے لیے حتمی جملوں کا زمینی سچائی سے موازنہ کیا گیا۔ CSL کے لیے ہم نے ڈیٹا سیٹ کو تربیتی ڈیٹا کے لیے 80 فیصد اور ٹیسٹنگ ڈیٹا کے لیے 20 فیصد میں تقسیم کیا۔ جیسا کہ جدول 5 میں دکھایا گیا ہے، ہمارا مجوزہ ملٹی فیچر ماڈل (STMF) فل فریم اور کلیدی پوائنٹ فیچرز کا استعمال کرتے ہوئے ایک بہتر نتیجہ حاصل کر سکتا ہے اور صرف فل فریم فیچر کا استعمال کرتے ہوئے ماڈل کے مقابلے WER کو 0.8 تک کم کر سکتا ہے [23]۔ ہمارا بہترین نتیجہ توجہ کے طریقہ کار (STAMF) کا استعمال کرتے ہوئے مجوزہ ملٹی فیچر ماڈل کے ذریعے حاصل کیا گیا، جس نے WER کے لیے 0.7 حاصل کیا۔ توجہ کی پرت نے اب بھی نتیجہ میں قدرے بہتری لائی ہے حالانکہ CSL ڈیٹاسیٹ میں کوئی عیب دار فریم نہیں تھا۔ اس سے ثابت ہوتا ہے کہ توجہ کی پرت کا ماڈل پر اثر پڑتا ہے۔ مجوزہ ملٹی فیچر ماڈل خود جدید ترین طریقوں سے برتر ہے اور توجہ کی تہہ CSL ڈیٹاسیٹ پر WER سکور کو کم کرنے میں معاون ہے۔ CSL پر کلیدی نکتہ ایک اہم اثر دیتا ہے کیونکہ یہ دوسرے کثیر فیچر طریقہ [17] کے مقابلے میں موثر معلومات دے سکتا ہے جس میں ہاتھوں، چہرے اور جسم کے پوز کو استعمال کیا جاتا ہے۔
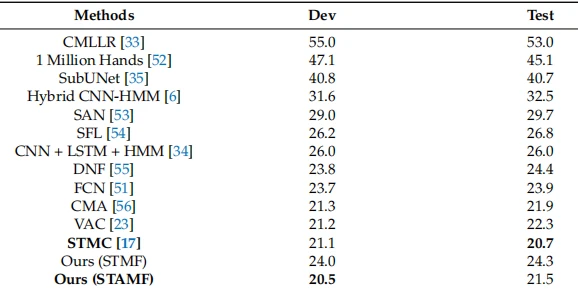
RWTH-PHOENIX ڈیٹاسیٹ کے لیے، ہم نے تربیت اور جانچ کے ڈیٹا کو تقسیم کرنے کے لیے مصنوعی ترتیب کا استعمال کیا۔ ڈیٹاسیٹ کو تربیت کے لیے 5672 نمونہ ویڈیوز، خود کی تصدیق کے لیے 540 نمونے کی ویڈیوز، اور جانچ کے لیے 629 نمونہ ویڈیوز میں تقسیم کیا گیا تھا۔ جیسا کہ جدول 6 میں دکھایا گیا ہے، فل فریم کا استعمال کرتے ہوئے ہمارے مجوزہ ملٹی فیچر ماڈل (STMF) کا نتیجہ اور کلیدی پوائنٹ کی خصوصیات میں 24 فیصد WER تھا، اور ہمارا بہترین نتیجہ 20.5 فیصد تھا، جو توجہ ماڈیول (STAMF) کا استعمال کرتے ہوئے مجوزہ ماڈل کے ذریعے حاصل کیا گیا تھا۔ تربیت کے نتیجے میں. ٹیسٹ کے نتائج [17] کے مقابلے میں دوسرے نمبر پر ہیں کیونکہ وہ ان پٹ کے طور پر زیادہ خصوصیات استعمال کرتے ہیں۔ تاہم، توجہ کے ماڈیول نے RWTHPHOENIX ڈیٹاسیٹ کے لیے WER سکور کو کم کرنے میں اہم کردار ادا کرنے کے لیے ثابت کیا ہے۔ CSL ڈیٹاسیٹ کے لیے ہمارے نتیجے سے مختلف، ملٹی اسٹریم والے ہمارے مجوزہ ماڈل نے زیادہ سے زیادہ نتیجہ حاصل نہیں کیا۔ اس کی وجہ یہ ہے کہ RWTH-PHOENIX ڈیٹاسیٹ میں بہت سے عیب دار فریم ہیں۔ ان کا ایک دھندلا حصہ ہے، خاص طور پر ہاتھ کے حصے میں۔ یہ فریم لاپتہ یا غلط کیپوائنٹ پوزیشن کی وجہ سے متضاد کلیدی پوائنٹ کی معلومات دیتا ہے اور ماڈل کو کم بہترین بناتا ہے۔ یہ مسئلہ ہمارے مجوزہ ملٹی فیچر ماڈل میں توجہ کی پرت کو شامل کرکے حل کیا جاتا ہے، جو درست معلومات کو منتخب کرنے میں مدد کرتا ہے اور بغیر توجہ کے مجوزہ کثیر فیچر ماڈل کے مقابلے میں نمایاں بہتری لاتا ہے۔
جدول 5۔ CSL ڈیٹاسیٹ پر WER کارکردگی کا موازنہ۔
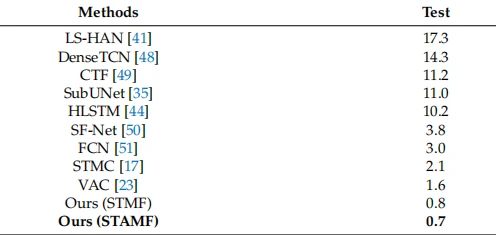
جدول 6. RWTH-PHOENIX ڈیٹاسیٹ پر WER کارکردگی کا موازنہ۔
4.7.3 معیار کا نتیجہ
ہم نے اپنے ماڈل کی ایک کوالٹیٹیو جانچ بھی کی، شناخت کے نتائج کے تصور کا استعمال کرتے ہوئے۔ شکل 8 جملوں کے تین نمونوں کا استعمال کرتے ہوئے ہماری کوالیٹیٹو تشخیص کی تفصیلات دکھاتی ہے۔ پہلا جملہ 10 الفاظ پر مشتمل ہے اور فریموں کی کل تعداد 220 ہے۔ دوسرا جملہ 12 الفاظ پر مشتمل ہے اور فریموں کی کل تعداد 168 ہے۔ تیسرا جملہ 9 الفاظ پر مشتمل ہے اور فریموں کی کل تعداد 135 ہے۔
نمونے کے نتائج سے پتہ چلتا ہے کہ ماڈلز کے ذریعہ کچھ چمکوں کی صحیح پیش گوئی نہیں کی گئی ہے، اور ہم اسے سرخ نشان سے ظاہر کرتے ہیں۔ تاہم، یہ اب بھی درست الفاظ کی اکثریت کا اندازہ لگا سکتا ہے۔ غلطیوں کی سب سے بڑی تعداد پہلے جملے میں ہے، جس کا فریم نمبر سب سے طویل ہے۔ اس جملے میں، جملے کے آغاز میں زیادہ غلطیاں ہیں، ابتدائی الفاظ کے لیے متعدد اشاروں کی وجہ سے صرف تھوڑا سا مختلف ہونے کی وجہ سے حدوں میں فرق کرنا مشکل ہے۔ تاہم، کثیر خصوصیت اور توجہ کے ساتھ مجوزہ ماڈل (STAMF) مزید الفاظ کی شناخت کر سکتا ہے، لیکن ان پر غلط لیبل لگا دیا گیا تھا۔ مزید یہ کہ، توجہ کے ساتھ ماڈل کی ترتیب، بغیر توجہ کے مجوزہ ماڈل کے مقابلے میں، مزید دو نمونوں کے لیے ایک بہتر شناختی نتیجہ حاصل کرتی ہے۔

شکل 8. RWTH-PHOENIX ڈیٹاسیٹ [33,39] کی مختلف کنفیگریشن کا استعمال کرتے ہوئے شناختی نتیجہ کی کوالٹیٹو تشخیص۔ غلط پیشن گوئی کی چمک سرخ میں نشان لگا دیا گیا ہے.
5. نتائج
اس مقالے میں، ہم CSLR کے لیے ایک ناول spatiotemporal attentive multi-feature (STAMF) پیش کرتے ہیں، جس کا مقصد مقامی اور وقتی ارتباط اور بصری خصوصیات کی ترتیب سے اہم معلومات اور اختتام سے آخر تک نقطہ نظر میں کلیدی خصوصیات کو سیکھنا ہے۔ ہمارے فریم ورک میں، ایک مقامی ماڈیول RGB ڈیٹا سے مکمل فریم فیچر اور باڈی کلیدی پوائنٹس کے کلیدی پوائنٹس کے ساتھ تیار کیا گیا تھا، جس میں ہاتھ ملٹی فیچرز کے طور پر شامل ہیں۔ ملٹی اسٹریم فیچر ان پٹ کے طور پر استعمال ہونے والے ان مجموعوں نے جدید ترین اپروچ کے مقابلے میں اعلیٰ کارکردگی دی جو صرف مکمل فریم کا استعمال کرتا ہے یا اس طریقہ کار کے مقابلے میں شکل 8۔ RWTH کی مختلف ترتیب کا استعمال کرتے ہوئے شناختی نتائج کا معیاری جائزہ -فینکس ڈیٹاسیٹ [33,39]۔ غلط پیشن گوئی کی چمک سرخ میں نشان لگا دیا گیا ہے. 5. نتیجہ اس مقالے میں، ہم CSLR کے لیے ایک ناول spatiotemporal attentive multi-feature (STAMF) پیش کرتے ہیں، جس کا مقصد مقامی اور وقتی ارتباط اور بصری خصوصیات کی ترتیب سے اہم معلومات اور اختتام سے لے کر اہم نکات کی خصوصیات کو سیکھنا ہے۔ اختتامی نقطہ نظر. ہمارے فریم ورک میں، ایک مقامی ماڈیول RGB ڈیٹا سے مکمل فریم فیچر اور باڈی کلیدی پوائنٹس کے کلیدی پوائنٹس کے ساتھ تیار کیا گیا تھا، جس میں ہاتھ ملٹی فیچرز کے طور پر شامل ہیں۔ ملٹی اسٹریم فیچر ان پٹ کے طور پر استعمال ہونے والے ان امتزاج نے جدید ترین اپروچ کے مقابلے میں اعلیٰ کارکردگی دی جو صرف مکمل فریم استعمال کرتا ہے یا اس طریقہ کے مقابلے میں جو ایک اور کثیر فیچر کا مجموعہ استعمال کرتا ہے، خاص طور پر CSL ڈیٹاسیٹ کے لیے۔ اس کے بعد، ہم وقتی ڈومین میں اہم معلومات کو حاصل کرنے کے لیے عارضی پولنگ اور وقتی توجہ پر مشتمل ایک عارضی ماڈیول تجویز کرتے ہیں۔ دیر سے وقتی توجہ کا اضافہ اس ترتیب سے اہم خصوصیت حاصل کرنے کے قابل ہے جس میں غلط معلومات ہیں اور ہمارے مجوزہ کثیر فیچر ماڈل کے مقابلے میں نمایاں بہتری لاتی ہے۔ یہ ترتیب سیکھنے کو بہتر طریقے سے سیکھنے میں بھی مدد کرتا ہے اور CSL ڈیٹا سیٹ کے تجربے کی طرح کارکردگی کو بڑھاتا ہے۔ عام طور پر استعمال ہونے والے ڈیٹا سیٹس پر وسیع تجربات ہمارے مجوزہ ماڈل کی جدید ترین ماڈل پر برتری کو ظاہر کرتے ہیں جس میں WER اسکورز CSL ڈیٹا سیٹ کے لیے 50 فیصد سے زیادہ اور RWTH-PHOENIX ڈیٹاسیٹ کے لیے 5 فیصد کم ہوئے ہیں۔ مستقبل میں، ہم اپنے موجودہ ماڈل کے ساتھ ٹرانسفر لرننگ تکنیک کو لاگو کرنے کے ساتھ ساتھ اپنے جاری کام کو حقیقی صنعت میں لاگو کرنے کا ارادہ رکھتے ہیں۔
حوالہ جات
1. ڈریو، پی.؛ Rybach, D.; Deselaers, T.; زاہدی، ایم. Ney, H. اشاروں کی زبان کی شناخت کے نظام کے لیے تقریر کی شناخت کی تکنیک۔ انٹر اسپیچ 2007 کی کارروائی میں، بین الاقوامی اسپیچ کمیونیکیشن ایسوسی ایشن کی 8ویں سالانہ کانفرنس، انٹورپ، بیلجیم، 27-31 اگست 2007؛ صفحہ 2513–2516۔
2. اونگ، ایس سی ڈبلیو؛ رنگناتھ، ایس خودکار اشارے کی زبان کا تجزیہ: ایک سروے اور مستقبل لغوی معنی سے آگے۔ آئی ای ای ای ٹرانس۔ پیٹرن مقعد. مچ انٹیل۔ 2005، 27، 873–891۔ [کراس ریف] [پب میڈ]
3. ووگلر، سی.؛ Metaxas, D. امریکی اشاروں کی زبان کے بیک وقت پہلوؤں کو پہچاننے کا ایک فریم ورک۔ کمپیوٹنگ Vis. امیج انڈرسٹ۔ 2001، 81، 358–384۔ [کراس ریف]
4. Bowden, R.; ونڈریج، ڈی. قادر، ٹی. زیسرمین، اے۔ بریڈی، ایم. ایک لسانی فیچر ویکٹر فار دی ویژول انٹرپریٹیشن آف سائن لینگوئج۔ کمپیوٹر وژن (ECCV) پر یورپی کانفرنس کی کارروائی میں، پراگ، جمہوریہ چیک، 11-14 مئی 2004؛ صفحہ 390-401۔
5. کاسوکورتھی، این۔ روکاد، بی۔ بیدانی، ایس. ڈینیسن، ڈی اے امریکن سائن لینگوئج حروف تہجی کی شناخت ڈیپ لرننگ کا استعمال کرتے ہوئے۔ arXiv 2019, arXiv:1905.05487۔
6. کولر، او. زرگران، ایس. نی، ایچ. Bowden, R. گہری نشانی: Hybrid CNN-HMMs کے ذریعے مضبوط شماریاتی مسلسل اشارے کی زبان کی شناخت کو فعال کرنا۔ انٹر J. Comput Vis. 2018، 126، 1311–1325۔ [کراس ریف]
7. Pu, J.; چاؤ، ڈبلیو. Li, H. مسلسل اشاراتی زبان کی شناخت کے لیے تکراری اصلاح کے ساتھ پھیلا ہوا کنوولیشنل نیٹ ورک۔ مصنوعی ذہانت، اسٹاک ہوم، سویڈن، 13-19 جولائی 2018 پر ستائیسویں بین الاقوامی مشترکہ کانفرنس کی کارروائی میں؛ صفحہ 885-891۔
8. Pu, J.; چاؤ، ڈبلیو. Li, H. مسلسل اشاراتی زبان کی شناخت کے لیے تکراری الائنمنٹ نیٹ ورک۔ کمپیوٹر وژن اور پیٹرن کی شناخت پر IEEE کمپیوٹر سوسائٹی کانفرنس کی کارروائی میں، لانگ بیچ، CA، USA، 15-20 جون 2019؛ صفحہ 4160–4169۔
9. کمار، این. اشاروں کی زبان کی شناخت کے لیے حرکت کی رفتار پر مبنی انسانی چہرے اور ہاتھوں سے باخبر رہنا۔ الیکٹریکل، کمپیوٹر اور الیکٹرانکس، متھرا، انڈیا، 26-28 اکتوبر 2017 پر 2017 4ویں IEEE اتر پردیش سیکشن کی بین الاقوامی کانفرنس کی کارروائی میں؛ صفحہ 211-216۔
10. بھویان، ایم کے؛ گوہ، ڈی۔ بورا، پی کے دستخطی زبان کے لیے ایپلی کیشنز کے ساتھ ہاتھ کے اشارے کی شناخت کے لیے ایک فریم ورک۔ 2006 کی سالانہ انڈیا کانفرنس کی کارروائی میں، INDICON، نئی دہلی، انڈیا، 15-17 ستمبر 2006؛ صفحہ 1-6۔
11. داس، ایس پی؛ تالقدار، اے کے؛ سرما، کے کے اشارے کی زبان کی شناخت چہرے کے تاثرات کا استعمال کرتے ہوئے۔ پروسیڈیا کمپیوٹر سائنس کی کارروائی میں، کیرالہ، انڈیا، 10-13 اگست 2015؛ صفحہ 210-216۔
12. رستگو، آر. کیانی، کے. Escalera, S.; سبوکرو، ایم. اشاراتی زبان کی پیداوار: ایک جائزہ۔ کمپیوٹر وژن اور پیٹرن ریکگنیشن ورکشاپس (CVPRW)، نیش وِل، TN، USA، 19-25 جون 2021 پر IEEE/CVF کانفرنس کی 2021 کی کارروائی میں؛ صفحہ 3446–3456۔
13. ڈونگ، ایس. وانگ، پی. عباس، کے ڈیپ لرننگ اور اس کی ایپلی کیشنز پر ایک سروے۔ کمپیوٹنگ سائنس Rev. 2021, 40, 100379۔ [CrossRef]
14. Athitsos, V.; Neidle, C.; Sclaroff, S.; نیش، جے؛ سٹیفن، اے. یوآن، Q. تھنگالی، اے امریکن سائن لینگویج لیکسیکن ویڈیو ڈیٹاسیٹ۔ کمپیوٹر وژن اور پیٹرن ریکگنیشن ورکشاپس، سی وی پی آر ورکشاپس، اینکریج، الاسکا، 23-28 جون 2008 پر IEEE کمپیوٹر سوسائٹی کانفرنس کی 2008 کی کارروائی میں؛ صفحہ 1-8۔
15. بنجرتھ، جے. سٹین، ڈی. ڈریو، پی. نی، ایچ. Morrissey, S.; راستہ، اے. زیجل، ایل وی اے ٹی آئی ایس سائن لینگویج کارپس۔ زبان کے وسائل اور تشخیص پر چھٹی بین الاقوامی کانفرنس کی کارروائی میں، LREC 2008، ماراکیچ، مراکش، 28-30 مئی 2008؛ صفحہ 2943–2946۔
16. Papastratis، I.؛ Chatzikonstantinou، C.؛ Konstantinidis, D.; Dimitropoulos, K.; درس، پی. مصنوعی ذہانت کی ٹیکنالوجیز برائے اشاروں کی زبان۔ سینسر 2021, 21, 5843۔ [کراس ریف] [پب میڈ]
17. چاؤ، ایچ. چاؤ، ڈبلیو. Zhou, Y.; لی، ایچ. مسلسل اشارے کی زبان کی شناخت کے لیے مقامی-دنیاوی ملٹی کیو نیٹ ورک۔ AAAI 2020 کی کارروائی میں—مصنوعی ذہانت پر چونتیسویں AAAI کانفرنس، نیویارک، نیو یارک، USA، 7-12 فروری 2020؛ صفحہ 13009–13016۔
18. Gündüz, C.; پولات، H. ملٹی اسٹریم ڈیٹا فیوژن پر مبنی ترکی کی اشاروں کی زبان کی شناخت۔ ترک جے الیکٹر۔ انج. کمپیوٹنگ سائنس 2021، 29، 1171–1186۔ [کراس ریف]
19. Bohacek، M.؛ ہروز، ایم سائن پوز بیسڈ ٹرانسفارمر برائے ورڈ لیول سائن لینگویج ریکگنیشن۔ کمپیوٹر وژن ورکشاپس، WACVW، Waikoloa، HI، USA، 4-8 جنوری 2022 کی ایپلی کیشنز پر 2022 IEEE/CVF سرمائی کانفرنس کی کارروائی میں؛ صفحہ 182-191۔
20. واسوانی، A. توجہ صرف آپ کی ضرورت ہے۔ نیورل انفارمیشن پروسیسنگ سسٹمز، لانگ بیچ، CA، USA، 4-9 دسمبر 2017 پر کانفرنس کی کارروائی میں؛ صفحہ 1-11۔
21. چاؤ، ایم. این جی، ایم؛ Cai، Z.؛ چیونگ، KC مسلسل اشاراتی زبان کی پہچان کے لیے مکمل طور پر آغاز کے نیٹ ورکس پر مبنی خود توجہ۔ سامنے والا۔ آرٹیف انٹیل۔ اپل 2020، 325، 2832–2839۔
22. Camgöz, NC; کولر، او۔ Hadfifield, S.; Bowden, R. سائن لینگویج ٹرانسفارمرز: مشترکہ آخر سے آخر میں اشارے کی زبان کی شناخت اور ترجمہ۔ کمپیوٹر وژن اور پیٹرن کی شناخت پر IEEE کمپیوٹر سوسائٹی کانفرنس کی کارروائی میں، سیئٹل، WA، USA، 14-19 جون 2020؛ صفحہ 10020–10030۔
23. منٹ، Y.؛ ہاؤ، اے. چائی، ایکس۔ چن، X. مسلسل اشارے کی زبان کی شناخت کے لیے بصری سیدھ میں رکاوٹ۔ کمپیوٹر وژن (ICCV) پر IEEE انٹرنیشنل کانفرنس کی کارروائی میں، مونٹریال، BC، کینیڈا، 10-17 اکتوبر 2021؛ صفحہ 11542–11551۔
24. گو، ڈی. چاؤ، ڈبلیو. وانگ، ایم؛ Li, H. اعداد و شمار کے اضافے کے ساتھ موافقت پذیر HMMs پر مبنی اشارے کی زبان کی شناخت۔ تصویری پروسیسنگ (ICIP) پر IEEE بین الاقوامی کانفرنس کی کارروائی میں، Phoenix, AZ، USA، 25-28 ستمبر 2016؛ صفحہ 2876–2880۔
25. ہوانگ، جے؛ چاؤ، ڈبلیو. لی، ایچ. لی، ڈبلیو سائن لینگویج ریکگنیشن 3D Convolutional Neural Networks کا استعمال کرتے ہوئے۔ ملٹی میڈیا اور ایکسپو (ICME) پر IEEE انٹرنیشنل کانفرنس کی کارروائی میں، ٹورین، اٹلی، 29 جون تا 3 جولائی 2015؛ صفحہ 1-6۔
26. گو، ڈی. چاؤ، ڈبلیو. لی، ایچ. وانگ، ایم آن لائن ابتدائی-دیر فیوژن اشارے کی زبان کی شناخت کے لیے انکولی HMM پر مبنی۔ ACM ٹرانس۔ ملٹی میڈ کمپیوٹنگ کمیون اپل 2017، 14، 1-18۔ [کراس ریف]
27. الحمادی، ایم. محمد، جی؛ رکن، S. 3DCNN کا استعمال کرتے ہوئے اشاروں کی زبان کے لیے ہاتھ کے اشارے کی شناخت۔ IEEE رسائی 2020, 8, 79491–79509۔ [کراس ریف]
28. رضا، ایچ. جوز، V. MS-ASL: امریکی اشاروں کی زبان کو سمجھنے کے لیے ایک بڑے پیمانے پر ڈیٹا سیٹ اور بینچ مارک۔ arXiv 2019, arXiv:1812.01053۔
29. لی، ڈی. اوپازو، سی آر؛ یو، ایکس؛ لی، ایچ. ویڈیو سے لفظ کی سطح کی گہری اشاروں کی زبان کی شناخت: ایک نیا بڑے پیمانے پر ڈیٹا سیٹ اور طریقوں کا موازنہ۔ کمپیوٹر وژن، WACV، Snowmass Village، CO، USA، 1-5 مارچ 2020 کی ایپلی کیشنز پر 2020 IEEE سرمائی کانفرنس کی کارروائی میں؛ صفحہ 1448–1458۔
30. Pu, J.; چاؤ، ڈبلیو. Li, H. ملٹی ماڈل خصوصیات کے ساتھ اشارے کی زبان کی پہچان۔ ملٹی میڈیا پر پیسیفک رم کانفرنس کی کارروائی میں، ژیان، چین، 15-16 ستمبر 2016؛ صفحہ 252-261۔
31. جیانگ، ایس. سورج، B. وانگ، ایل. بائی، وائی۔ لی، کے؛ Fu, Y. Skeleton Aware Multi-modal Sign Language Recognition. کمپیوٹر وژن اور پیٹرن ریکگنیشن ورکشاپس پر IEEE کمپیوٹر سوسائٹی کانفرنس کی کارروائی میں، نیش وِل، TN، USA، 19-25 جون 2021؛ صفحہ 3408–3418۔
32. Sidig، AAI؛ لقمان، ایچ. محمود، ایس. موہندس، ایم کے اے آر ایس ایل: عربی اشاراتی زبان کا ڈیٹا بیس۔ ACM ٹرانس۔ ایشیائی کم ریزور۔ لینگ Inf. پروسیسنگ 2021، 20، 1-19۔ [کراس ریف]
33. کولر، او. فورسٹر، جے؛ Ney, H. مسلسل اشارے کی زبان کی شناخت: ایک سے زیادہ دستخط کرنے والوں کو سنبھالنے والے بڑے الفاظ کے شماریاتی شناخت کے نظام کی طرف۔ کمپیوٹنگ Vis. امیج انڈرسٹ۔ 2015، 141، 108–125۔ [کراس ریف]
34. کولر، او. کامگوز، این سی؛ Ney, H. ملٹی اسٹریم CNN-LSTM-HMMs کے ساتھ کمزور نگرانی میں سیکھنے کو اشاروں کی زبان کے ویڈیوز میں ترتیب وار ہم آہنگی دریافت کرنے کے لیے۔ آئی ای ای ای ٹرانس۔ پیٹرن مقعد. مچ انٹیل۔ 2020، 42، 2306–2320۔ [کراس ریف] [پب میڈ]
35. کامگوز، این سی؛ Hadfifield, S.; کولر، او۔ Bowden, R. SubUNets: آخر سے آخر تک ہاتھ کی شکل اور مسلسل اشارے کی زبان کی شناخت۔ کمپیوٹر وژن (ICCV) پر 2017 IEEE بین الاقوامی کانفرنس کی کارروائی میں، وینس، اٹلی، 22-29 اکتوبر 2017؛ صفحہ 3075–3084۔
36. ڈونگ، سی. Loy, CC; He, K.; تانگ، X. تصویری سپر ریزولیوشن ڈیپ کنوولوشنل نیٹ ورکس کا استعمال کرتے ہوئے۔ آئی ای ای ای ٹرانس۔ پیٹرن مقعد. مچ انٹیل۔ 2014، 38، 295–307۔ [کراس ریف] [پب میڈ]
37. بریسیم، کے کے؛ ایڈمز، ایل سی؛ Erxleben، C.؛ ہیم، بی؛ Niehues, SM; Vahldiek, JL سینے کے ریڈیوگراف کی درجہ بندی کے لیے مختلف گہری سیکھنے کے فن تعمیر کا موازنہ کرنا۔ سائنس نمائندہ 2020، 10، 13590۔ [کراس ریف]
38. سورج، K.؛ Xiao, B.; لیو، ڈی. وانگ، جے ڈیپ ہائی ریزولوشن ریپریزنٹیشن لرننگ فار ہیومن پوز اسٹیمیشن۔ کمپیوٹر وژن اور پیٹرن کی شناخت پر IEEE کمپیوٹر سوسائٹی کانفرنس کی کارروائی میں، لانگ بیچ، CA، USA، 15-20 جون 2019؛ صفحہ 5686–5696۔
39. کولر، او. زرگران، ایس. Ney، H. دوبارہ سائن: ڈیپ ریکرنٹ CNN-HMMs کے ساتھ اینڈ ٹو اینڈ سیکوینس ماڈلنگ کو دوبارہ منسلک کیا۔ کمپیوٹر ویژن اور پیٹرن ریکگنیشن (CVPR) پر 2017 IEEE کانفرنس کی پرو سیڈنگز میں، ہونولولو، HI، USA، 21-26 جولائی 2017؛ صفحہ 3416–3424۔
40. چاؤ، ایچ. چاؤ، ڈبلیو. Li, H. مسلسل اشاروں کی زبان کی شناخت کے لیے ڈائنامک سیوڈو لیبل ڈی کوڈنگ۔ ملٹی میڈیا اینڈ ایکسپو (ICME) پر 2019 IEEE انٹرنیشنل کانفرنس کی کارروائی میں، شنگھائی، چین، 18-21 جولائی 2019؛ صفحہ 1282–1287۔
41. ژاؤ، Q.؛ چانگ، ایکس؛ ژانگ، ایکس۔ Liu, X. ویڈیو پر مبنی اشاراتی زبان کی پہچان بغیر وقتی تقسیم کے۔ مصنوعی ذہانت پر بتیسویں AAAI کانفرنس کی کارروائی میں، نیو اورلینز، LA، USA، 2–7 فروری 2018؛ صفحہ 2257–2264۔
42. قبریں، A.؛ فرنانڈیز، ایس. گومز، ایف۔ Schmidhuber, J. کنکشنسٹ وقتی درجہ بندی: ریکرنٹ نیورل نیٹ ورکس کے ساتھ غیر منقسم ترتیب ڈیٹا کو لیبل لگانا۔ ICML '06 کی کارروائی میں: مشین لرننگ پر 23ویں بین الاقوامی کانفرنس کی کارروائی، پٹسبرگ، PA، USA، 25-29 جون 2006؛ صفحہ 369-376۔
43. قبریں، A.؛ لیوکی، ایم. فرنانڈیز، ایس. Bertolami, R.; بنک، ایچ. شمڈوبر، جے۔ ایک ناول کنکشنسٹ سسٹم فار غیر محدود ہینڈ رائٹنگ ریکگنیشن۔ آئی ای ای ای ٹرانس۔ پیٹرن مقعد. مچ انٹیل۔ 2009، 31، 855–868۔ [کراس ریف]
44. گو، ڈی. چاؤ، ڈبلیو. لی، ایچ. وانگ، ایم. ہیرارکیکل LSTM برائے اشاراتی زبان کے ترجمہ۔ مصنوعی ذہانت پر AAAI کانفرنس کی کارروائی میں، نیو اورلینز، LA، USA، 2–7 فروری 2018؛ صفحہ 6845–6852۔
45. رحمان، ایم ایم؛ Watanobe, Y.; Nakamura, K. کوڈ کی تشخیص اور مرمت کے لیے ایک دو طرفہ LSTM زبان کا ماڈل۔ ہم آہنگی 2021، 13، 247۔ [کراس ریف]
46. Hu, W.; Cai، M. چن، کے؛ ڈنگ، ایچ. سورج، ایل. لیانگ، ایس. Mo, X.; Huo، Q. ایک انٹرپولیٹڈ CTC اور جالی سے پاک MMI آبجیکٹو فنکشن کے ذریعے آف لائن ہینڈ رائٹنگ کی شناخت کے لیے ترتیب امتیازی تربیت۔ دستاویز کے تجزیہ اور شناخت پر بین الاقوامی کانفرنس کی کارروائی میں، ICDAR، کیوٹو، جاپان، 9-15 نومبر 2017؛ جلد 1، صفحہ 61-66۔
47. یوشیمورا، ٹی. حیاشی، ٹی. تاکیدا، K.؛ Watanabe, S. آخر سے آخر تک خودکار تقریر کی شناخت CTC پر مبنی صوتی سرگرمی کی کھوج کے ساتھ مربوط ہے۔ ICASSP کی کارروائی میں، صوتی، تقریر اور سگنل پروسیسنگ پر IEEE بین الاقوامی کانفرنس، بارسلونا، اسپین، 4-8 مئی 2020؛ صفحہ 6999–7003۔
48. گو، ڈی. وانگ، ایس. تیان، Q. وانگ، ایم ڈینس ٹیمپورل کنولوشن نیٹ ورک فار سائن لینگوئج ٹرانسلیشن۔ آرٹیفیشل انٹیلی جنس (IJCAI-19) پر اٹھائیسویں بین الاقوامی مشترکہ کانفرنس کی کارروائی میں، مکاؤ، چین، 10-16 اگست 2017؛ صفحہ 744-750۔
49. وانگ، ایس. گو، ڈی؛ چاؤ، ڈبلیو. غذا، ز. وانگ، ایم کنکشنسٹ ٹیمپورل فیوژن فار سائن لینگوئج ٹرانسلیشن۔ ملٹی میڈیا پر 26ویں ACM بین الاقوامی کانفرنس کی کارروائی میں، سیول، کوریا، 22-26 اکتوبر 2018؛ صفحہ 1483–1491۔
50. یانگ، زیڈ؛ Shi, Z. SF-Net: مسلسل اشاراتی زبان کی شناخت کے لیے سٹرکچرڈ فیچر نیٹ ورک۔ arXiv 2019, arXiv:1908.01341۔
51. چینگ، کے ایل؛ یانگ، زیڈ؛ چن، Q. Tai, Y. مسلسل اشاراتی زبان کی پہچان کے لیے مکمل طور پر کنوولیشنل نیٹ ورکس۔ کمپیوٹر وژن پر یورپی کانفرنس کی کارروائی میں، گلاسگو، یوکے، 23-28 اگست 2020؛ صفحہ 697-714۔
52. کولر، او. نی، ایچ. بوڈن، آر ڈیپ ہینڈ: 1 ملین ہینڈ امیجز پر سی این این کو کیسے تربیت دی جائے جب آپ کا ڈیٹا مسلسل اور کمزور لیبل لگا ہوا ہو۔ کمپیوٹر ویژن اور پیٹرن ریکگنیشن (CVPR) پر 2016 IEEE کانفرنس کی کارروائی میں، لاس ویگاس، NV، USA، 27-30 جون 2016؛ صفحہ 3793–3802۔
53. سلیمانی، ایف بی سیاق و سباق کے معاملات: اشاروں کی زبان کی شناخت کے لیے خود توجہ۔ arXiv 2021, arXiv:2101.04632۔
54. نیو، زیڈ؛ Mak, B. مسلسل اشاراتی زبان کی پہچان کے لیے ملٹی سٹیٹ سائن گلوز کی سٹوکاسٹک فائن گرینڈ لیبلنگ۔ کمپیوٹر وژن پر یورپی کانفرنس کی کارروائی میں، گلاسگو، یوکے، 23-28 اگست 2020؛ صفحہ 1-16۔
55. Cui، R.؛ لیو، ایچ. ژانگ، سی. تکراری تربیت کے ذریعے مسلسل اشاراتی زبان کی پہچان کے لیے ایک گہرا اعصابی فریم ورک۔ آئی ای ای ای ٹرانس۔ ملٹی میڈ 2019، 21، 1880–1891۔ [کراس ریف]
56. Pu, J.; چاؤ، ڈبلیو. Hu, H.; لی، ایچ کراس موڈیلٹی اگمینٹیشن کے ذریعے مسلسل اشارے کی زبان کی پہچان کو بڑھانا۔ ملٹی میڈیا، سیئٹل، WA، USA، 12-16 اکتوبر 2020 پر 28ویں ACM بین الاقوامی کانفرنس کی کارروائی میں؛ صفحہ 1497-1505۔


